

بله، با یک کامپیوتر ویندوزی ۶۴ بیتی و رم کافی (بهتر است ۱۶ گیگ) میتوانید مدلهای رایگان هوش مصنوعی را بدون اینترنت و بدون اشتراک ماهانه اجرا کنید؛ فقط یک بار برای گرفتن برنامه و مدل به اینترنت نیاز دارید.
- از کجا: سه راه ساده دارید: قابلیت WebAI در مرورگر Opera One، برنامهٔ LM Studio با رابط گرافیکی و ابزار Ollama برای کاربران حرفهایتر.
- چه چیزی: یک مدل کوچک مثل Gemma ۴ E۲B برای ۸ گیگ رم یا Gemma ۴ E۴B برای ۱۶ گیگ رم.
- چطور: برنامه را نصب کنید، مدل را یک بار دانلود کنید و بعد بدون اینترنت با آن چت کنید؛ مراحل هر روش پایینتر آمده است.
- منبع امن: برنامه و مدل را فقط از سایت رسمی Opera، LM Studio و Ollama بگیرید و در Ollama مدلهای cloud را که آنلاین اجرا میشوند انتخاب نکنید.
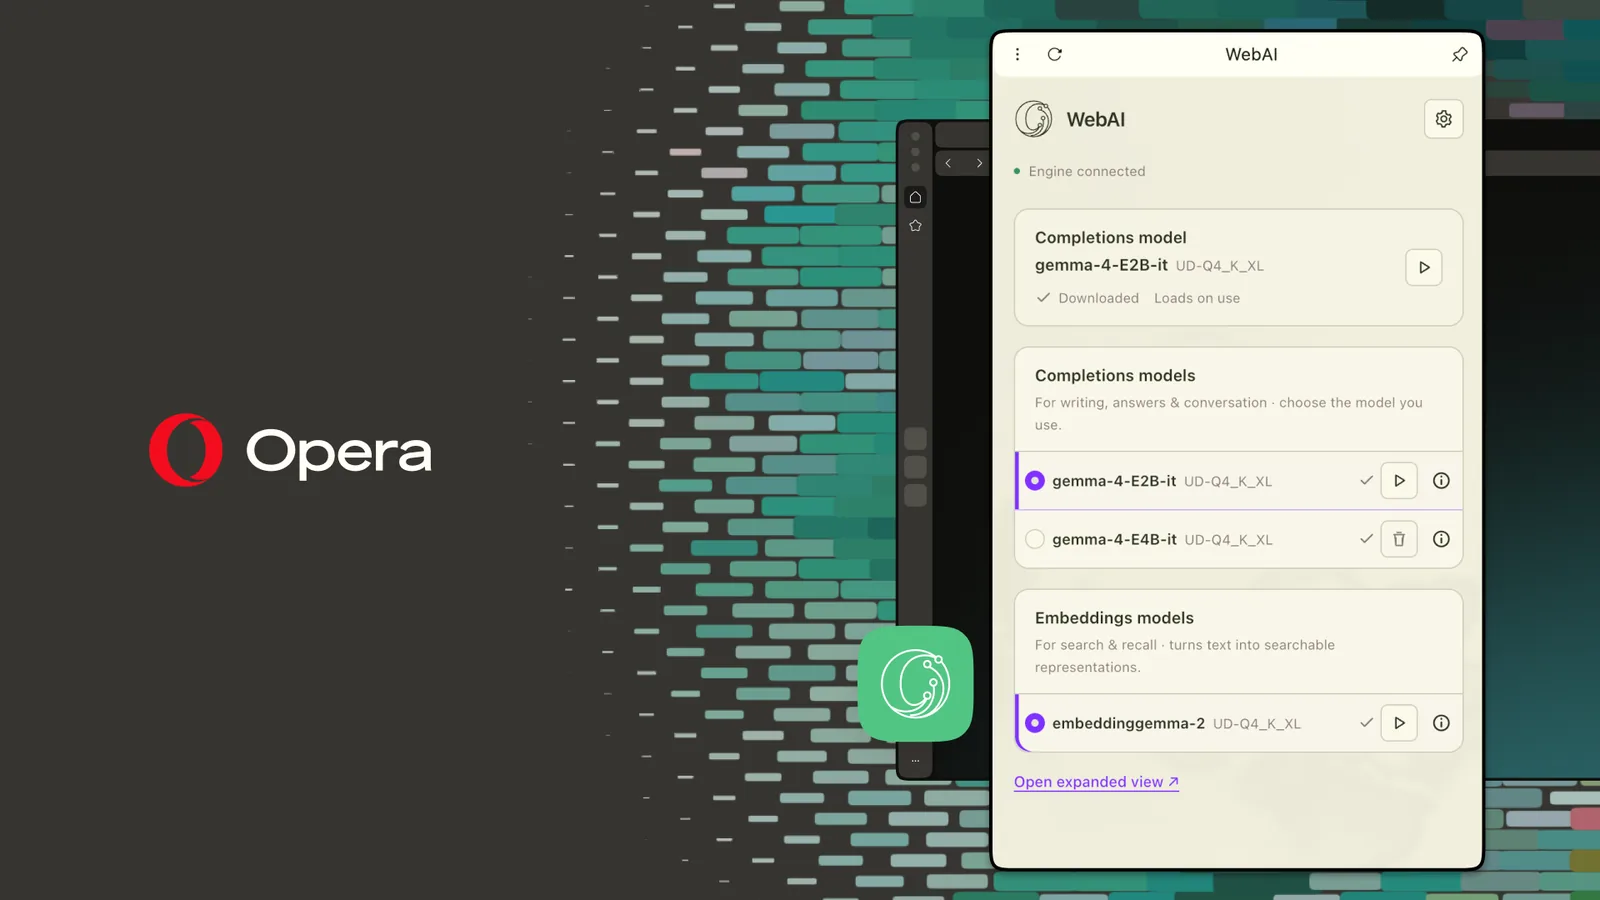
خبر تازه این است که Opera روز ۲۷ اکتبر ۲۰۲۶ قابلیت WebAI را بهصورت پیشنمایش اولیه منتشر کرد؛ به گفتهٔ وبلاگ رسمی Opera رسمی این قابلیت مدل هوش مصنوعی را روی خود کامپیوتر اجرا میکند و نیازی به نصب برنامهٔ جدا یا کلید API ندارد. همزمان چند مدل کوچک مخصوص اجرای محلی هم آمدهاند، از جمله خانوادهٔ LFM۳ شرکت Liquid AI در همین ۲۷ اکتبر و مدل Nemotron ۳.۵ Bolt E۴B انویدیا در ۲۳ اکتبر. در ادامه میبینید چه سختافزاری لازم است و هر روش را چطور قدمبهقدم راه بیندازید.
هوش مصنوعی آفلاین چه فرقی با ChatGPT آنلاین دارد
وقتی با ChatGPT یا سرویسهای مشابه کار میکنید، متن شما به سرورهای شرکت سازنده فرستاده میشود و جواب از همانجا برمیگردد. در هوش مصنوعی آفلاین (یا محلی) خود مدل روی هارد شما ذخیره میشود و پردازنده و کارت گرافیک کامپیوتر خودتان جواب را میسازند. نتیجه سه مزیت مهم است:
حریم خصوصی
متن، فایل و سؤالهای شما از کامپیوتر بیرون نمیرود؛ برای اسناد کاری و شخصی امنتر است.
کار بدون اینترنت
بعد از گرفتن مدل، وقتی اینترنت کند یا قطع است هم میشود ترجمه، خلاصهنویسی و نوشتن را ادامه داد.
بدون اشتراک
مدلهای باز رایگاناند؛ نه حساب خارجی لازم است و نه پرداخت ارزی برای اشتراک.
برای کاربر ایرانی این آخری مهمتر از همه است. Opera هم در اطلاعیهٔ مطبوعاتی رسمی تأکید کرده که کاربر هوش مصنوعی محلی به اشتراک و حساب کاربری نیاز ندارد و دادهها روی دستگاه میماند. البته مدلهای محلی کوچکتر از مدلهای بزرگ آنلایناند؛ برای کارهای روزمره خوباند اما در استدلالهای پیچیده به پای نسخههای ابری نمیرسند.
سختافزار لازم برای اجرای مدلهای محلی
سه قطعه بیشترین اثر را دارند: رم (چون مدل هنگام اجرا در حافظه بار میشود)، کارت گرافیک و حافظهٔ آن (VRAM) که سرعت جواب را چند برابر میکند، و SSD برای نگهداشتن فایل مدلها که هر کدام چند گیگابایتاند. طبق صفحهٔ سیستم مورد نیاز LM Studio رسمی در ویندوز دستکم ۱۶ گیگ رم و ۴ گیگ VRAM اختصاصی پیشنهاد میشود و پردازنده باید از دستورالعمل AVX۲ پشتیبانی کند.
| سطح سیستم | رم | کارت گرافیک | مدل مناسب |
|---|---|---|---|
| ضعیف | ۸ گیگ | گرافیک داخلی | مدلهای خیلی کوچک (حدود ۲ میلیارد پارامتر) |
| متوسط | ۱۶ گیگ | ۴ تا ۸ گیگ VRAM | مدلهای کوچک ۴ میلیاردی مثل Gemma ۴ E۴B |
| قوی | ۳۲ گیگ و بیشتر | ۱۲ گیگ VRAM و بیشتر | مدلهای ۱۲ تا ۲۶ میلیاردی |
ردیف «متوسط» با توصیهٔ رسمی LM Studio همخوان است؛ ردیفهای ضعیف و قوی برآورد ما از اندازهٔ مدلهاست غیررسمی. فضای خالی SSD را هم دستکم ۲۰ تا ۳۰ گیگ در نظر بگیرید تا بتوانید چند مدل را امتحان کنید. اگر SSD قدیمی دارید، اول سلامت SSD را در ویندوز بررسی کنید؛ و اگر به فکر ارتقای کارت گرافیک هستید، نکات حافظهٔ RTX ۴۰۶۰ پیش از خرید را ببینید، چون برای هوش مصنوعی مقدار VRAM از قدرت خام مهمتر است.
مشخصات سیستم خود را از کجا ببینم؟ مقدار رم و مدل پردازنده در تنظیمات ویندوز آمده است. مدل کارت گرافیک و مقدار حافظهٔ اختصاصی آن را در Task Manager، زبانهٔ Performance و بخش GPU ببینید. مسیر تنظیمات این است:
Settings → System → About
روش اول: WebAI در مرورگر Opera
به گفتهٔ Opera، WebAI فعلاً پیشنمایش اولیه است و فقط روی ویندوز ۶۴ بیتی با پردازندهٔ Intel یا AMD و مکهای Apple silicon کار میکند؛ مکهای اینتلی، لینوکس و ویندوز روی پردازندههای Arm پشتیبانی نمیشوند. اول Opera One را بهروز کنید. سپس در تنظیمات مرورگر گزینهٔ زیر را روشن کنید.
Settings → Opera AI → Enable Web AI API
با روشن کردن گزینه، یک مدل محلی سازگار دانلود میشود و ممکن است چند دقیقه طول بکشد. تا وقتی این گزینه را روشن نکنید چیزی دانلود نمیشود.
در تصویر رسمی Opera مدل پیشفرض نسخهای از Gemma ۴ گوگل است. سایتها و افزونهها فقط با اجازهٔ شما به این مدل دسترسی دارند.
یکی از افزونههای نمونهٔ Opera را نصب کنید و از منوی افزونهها باز کنید.
نکتهٔ مهم: WebAI بیشتر برای سایتها و افزونههاست و یک پنجرهٔ چت کامل مثل ChatGPT نیست. Opera در اطلاعیهٔ خود نوشته فعلاً Opera One آن را دارد و Opera GX و Opera Neon بعداً اضافه میشوند. اگر میخواهید مستقیم با مدل چت کنید، روش دوم سادهتر است.
روش دوم: LM Studio با رابط گرافیکی
LM Studio برنامهای با ظاهری شبیه پنجرهٔ چت است و برای ویندوز x۶۴ و Arm، مک و لینوکس عرضه میشود. طبق مستندات LM Studio رسمی، بعد از گرفتن فایل مدل، برنامه میتواند کاملاً آفلاین کار کند.
نسخهٔ ویندوز را از سایت رسمی LM Studio نصب و اجرا کنید.
به بخش جستوجوی مدلها بروید و یک مدل کوچک مثل Gemma را انتخاب کنید. برنامه کنار هر مدل نشان میدهد آیا با سختافزار شما جور است یا نه.
بعد از دانلود، مدل را از بالای پنجره بار کنید و در زبانهٔ Chat سؤال بپرسید.
برای امتحان، اینترنت را قطع کنید؛ چت باید همچنان جواب بدهد.
روش سوم: Ollama برای کاربران حرفهایتر
Ollama ابزاری سبک است که مدلها را از خط فرمان اجرا میکند و برنامههای دیگر میتوانند از طریق آن به مدل وصل شوند. طبق صفحهٔ رسمی Ollama رسمی، در ویندوز میتوانید آن را با این دستور در PowerShell نصب کنید.
irm https://ollama.com/install.ps۱ | iex
بعد از نصب، با این دستور نسخهٔ کوچک Gemma ۴ دانلود و اجرا میشود.
ollama run gemma۴:e۲b
حواستان باشد Ollama حالا مدلهای ابری هم دارد. مدلهایی که نامشان به cloud ختم میشود روی سرورهای Ollama اجرا میشوند، اینترنت میخواهند و به اعتبار یا اشتراک پولی نیاز دارند. برای کار آفلاین فقط مدلهای بدون این پسوند را بگیرید.
کدام مدل را انتخاب کنیم
قاعدهٔ ساده این است: حجم فایل مدل باید راحت در رم یا VRAM شما جا شود و جایی هم برای ویندوز بماند. طبق صفحهٔ Gemma ۴ در Ollama رسمی، نسخهٔ E۲B بین ۴٫۶ تا ۷٫۵ گیگ و نسخهٔ E۴B بین ۶٫۶ تا ۹٫۵ گیگ حافظه میگیرد. پس مدلهای «۴ گیگی» در عمل کمی بیشتر از ۴ گیگ جا میخواهند. Nemotron ۳.۵ Bolt E۴B انویدیا نسخهٔ فشردهای حدود ۴ گیگ دارد و LFM۳ هم مدل متنی حدود ۱ گیگی دارد، اما هر دو تازهاند و ممکن است هنوز در همهٔ برنامهها نباشند.
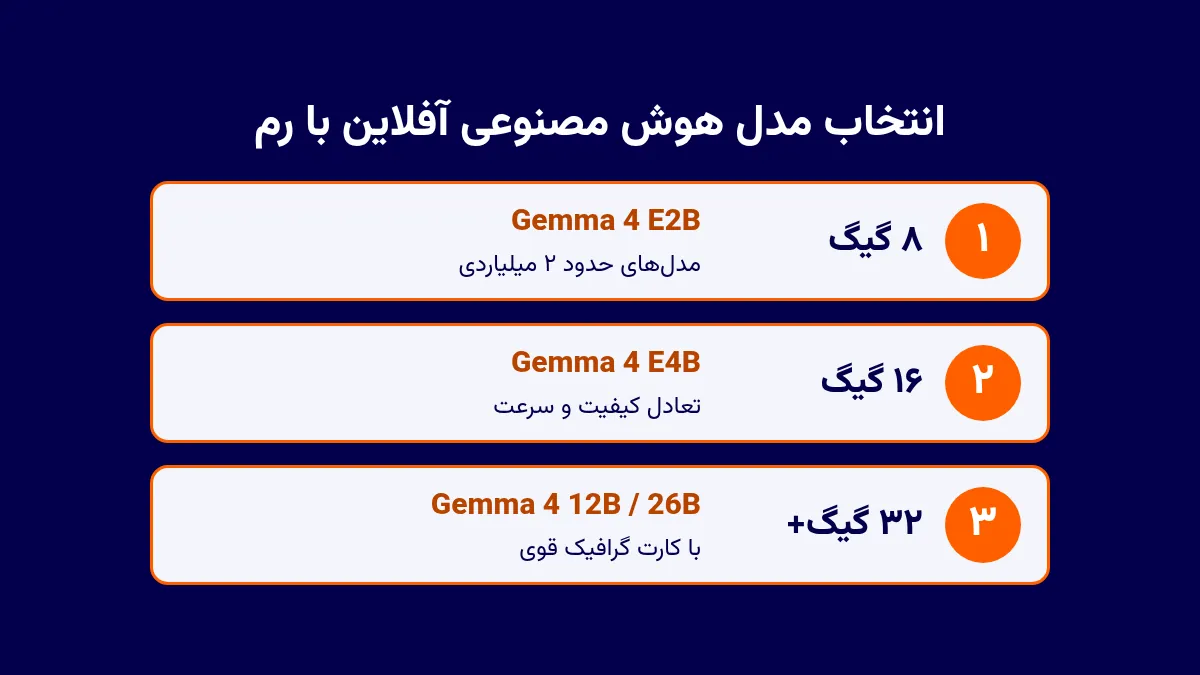
- ۸ گیگ رم: Gemma ۴ E۲B یا مدلهای حدود ۲ میلیاردی؛ برنامههای دیگر را ببندید.
- ۱۶ گیگ رم: Gemma ۴ E۴B؛ تعادل خوبی بین کیفیت و سرعت دارد.
- ۳۲ گیگ رم و کارت گرافیک قوی: Gemma ۴ ۱۲B یا ۲۶B برای جوابهای دقیقتر.
مشکلات رایج و راهحل
کندی جواب: اگر کارت گرافیک ندارید یا مدل در VRAM جا نمیشود، کار به پردازنده میافتد و کند میشود. یک مدل کوچکتر یا نسخهٔ فشردهتر (Q۴) را امتحان کنید.
پر شدن رم: مرورگر و برنامههای سنگین را ببندید و طول حافظهٔ گفتوگو (Context) را در تنظیمات LM Studio کم کنید.
شناخته نشدن کارت گرافیک: درایور کارت گرافیک را از سایت سازنده بهروز کنید و در لپتاپها دستگاه را به شارژر وصل کنید تا کارت گرافیک اصلی فعال شود. غیررسمی
خطای دانلود مدل: فایلهای مدل بزرگاند و با اینترنت ناپایدار نیمهکاره میمانند. دانلود را در ساعت خلوتتر دوباره شروع کنید و فضای خالی SSD را بررسی کنید.
آخر اینکه هوش مصنوعی محلی جای مراقبت از حسابها را نمیگیرد؛ رمزها و اطلاعات حساس را هیچوقت در چتها ننویسید و برای نگهداشتنشان از یک پسورد منیجر مطمئن استفاده کنید.
پاسخ به سوالات شما
بدون کارت گرافیک هم میشود هوش مصنوعی آفلاین اجرا کرد؟
بله. LM Studio و Ollama میتوانند مدل را فقط با پردازنده اجرا کنند، اما جوابها کندتر میآید. در این حالت مدلهای کوچک مثل Gemma 4 E2B را انتخاب کنید. LM Studio برای ویندوز دستکم ۴ گیگ VRAM اختصاصی را پیشنهاد میکند، نه الزامی.
لپتاپ با ۸ گیگ رم کافی است؟
برای مدلهای خیلی کوچک بله، به شرط اینکه برنامههای دیگر را ببندید. LM Studio برای ویندوز دستکم ۱۶ گیگ رم را توصیه میکند، پس با ۸ گیگ باید سراغ مدلهای حدود ۲ میلیاردی بروید و انتظار سرعت بالا نداشته باشید (غیررسمی).
مدلهای آفلاین فارسی میفهمند؟
مدلهایی مثل Gemma 4 روی دادههای چندزبانه آموزش دیدهاند و فارسی را تا حدی میفهمند، اما کیفیت فارسی در مدلهای کوچک پایینتر از انگلیسی است و ممکن است جملهها نادرست یا نیمهانگلیسی شوند (غیررسمی). مدلهای بزرگتر فارسی بهتری دارند.
اجرای هوش مصنوعی آفلاین امن است؟
از نظر حریم خصوصی امنتر از سرویسهای آنلاین است، چون متن شما از کامپیوتر بیرون نمیرود. فقط برنامه و مدل را از سایتهای رسمی بگیرید، در Ollama مدلهای cloud را که آنلاین اجرا میشوند با مدلهای محلی اشتباه نگیرید و در WebAI فقط به سایتهای مطمئن اجازهٔ دسترسی بدهید.

دیدگاهها